 sotto
Leader и followers
У каждой партиции один leader и несколько followers. Все чтения и записи идут через leader; followers непрерывно подтягивают данные с него и держат у себя точную копию лога.
Сколько копий держать — задаёт replication.factor (типично 3). Реплики размещают на РАЗНЫХ брокерах, а в облаке — желательно ещё и в разных зонах/стойках через broker.rack, чтобы пережить падение целого узла или AZ.
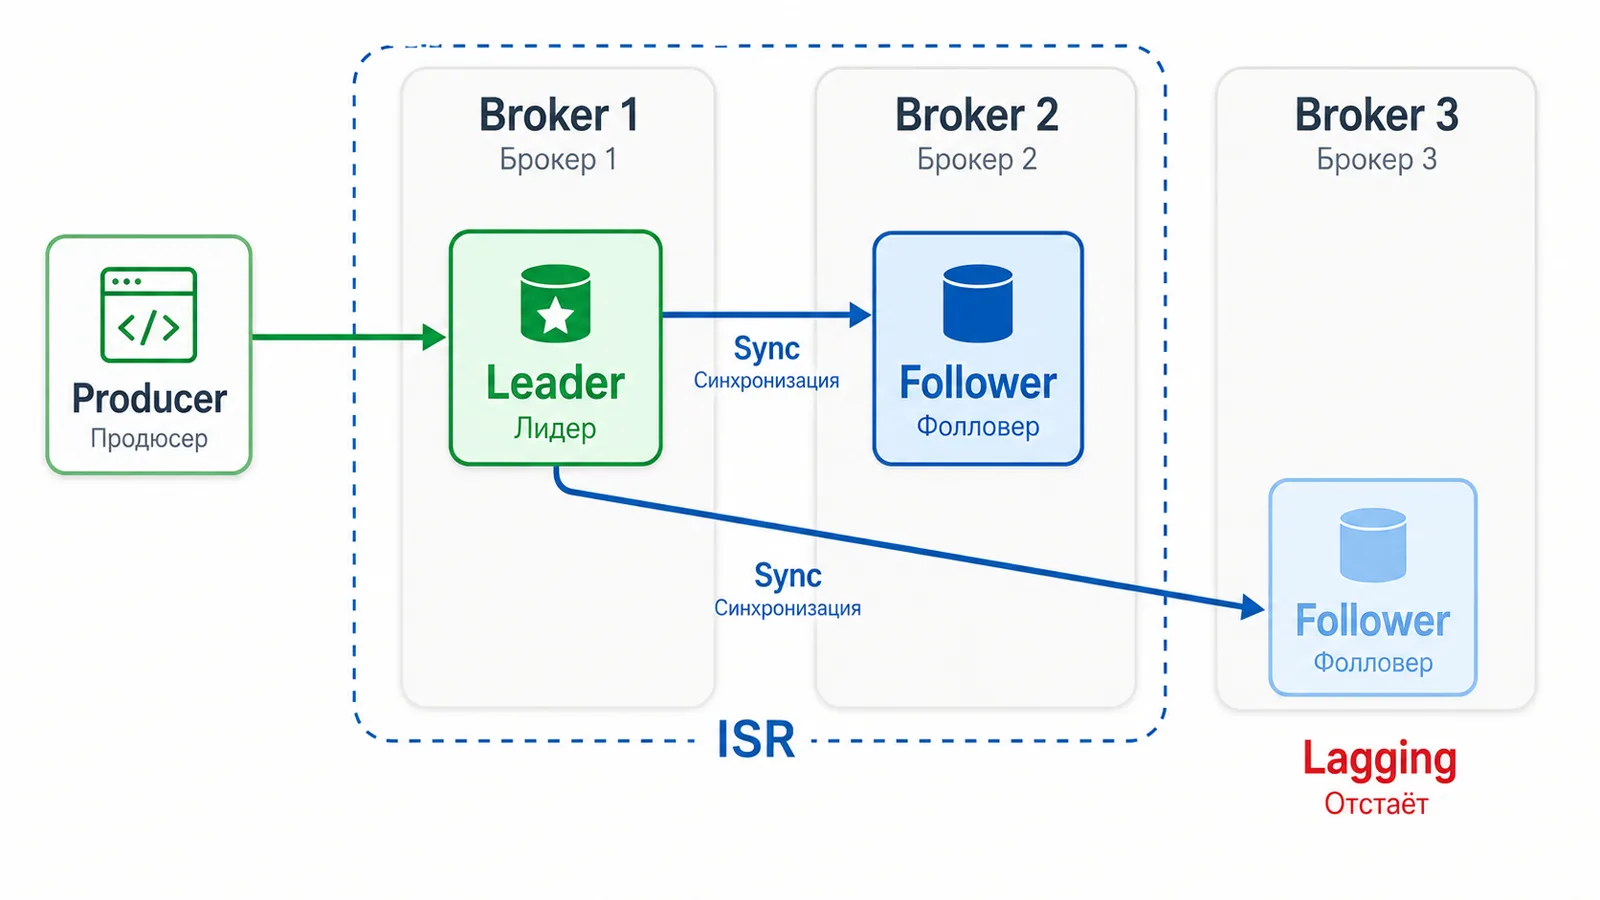
ISR (in-sync replicas)
ISR — подмножество реплик, которые «успевают» за leader (отстают не дольше replica.lag.time.max.ms). Только реплики из ISR имеют право стать новым лидером при failover — поэтому ISR определяет фактическую отказоустойчивость партиции.
Если follower отстаёт сильнее лимита, его выбрасывают из ISR. Постоянно скачущая ISR — признак проблем (медленная сеть/диски, перекос нагрузки) и тревожный сигнал в мониторинге.
Acks и min.insync.replicas
Это вторая половина истории про долговечность, начатой в уроке про producer. acks=all требует подтверждения от всех реплик ISR, а min.insync.replicas задаёт МИНИМАЛЬНОЕ число синхронных реплик, при котором запись вообще принимается.
Боевая комбинация — RF=3, min.insync.replicas=2, acks=all: переживаем падение одной реплики без потерь и без блокировки записи. Если ISR схлопывается ниже min.insync, продюсер получает NotEnoughReplicasException — это лучше, чем тихо потерять данные.
High watermark и видимость
Записи, реплицированные на все ISR-реплики, считаются «закоммиченными». Граница закоммиченных данных — high watermark (HW). Consumer'ы видят только записи ДО HW, даже если на leader уже лежат более свежие байты.
Это и обеспечивает корректность при failover: если новый лидер ещё не имел этих незакоммиченных данных, они «не существовали» с точки зрения consumer'ов — и не возникает ситуации «сообщение пропало после переключения». Видимость для приложений всегда консервативна по сравнению с физическим логом.
Выборы лидера и unclean election
При падении leader controller (нода с координацией метаданных) выбирает нового лидера ИЗ ISR. Если в ISR не осталось живых реплик, по умолчанию партиция уходит в offline — запись и чтение блокируются до восстановления.
Флаг unclean.leader.election.enable=true разрешает взять лидером реплику ВНЕ ISR. Доступность восстановится, но эта реплика отстала, и часть подтверждённых записей будет потеряна. Для критичных данных (платежи, события домена) почти всегда оставляют false: лучше временный простой записи, чем потеря committed-сообщений.
Rack awareness и сохранность
broker.rack помечает физическое размещение брокера (стойка/AZ). Kafka использует это для rack-aware размещения реплик: не складывает все реплики партиции в один rack, а распределяет по разным — падение целой стойки/AZ не лишает партицию доступного лидера.
Это «бесплатная» отказоустойчивость, но требует, чтобы топология брокеров действительно отражала физическую/облачную топологию — иначе rack awareness становится пустой меткой.
Как отвечать на собеседовании
Опишите leader/followers и RF=3 как боевой дефолт. Главное — ISR (только in-sync реплики имеют право стать лидером) и связка acks=all + min.insync.replicas=2 для долговечности. Объясните high watermark (consumer видит только закоммиченное → нет «исчезающих» сообщений при failover) и опасность unclean.leader.election.enable=true (доступность ценой подтверждённых данных). Завершите broker.rack для rack-aware размещения по AZ.