 sotto
Зачем кэш и что кэшировать
Кэш ускоряет повторное чтение дорогих или горячих данных, снимая нагрузку с БД. Источником истины остаётся база — кэш лишь её ускоряет, и его в любой момент можно потерять без потери данных.
Кэшировать стоит то, что часто читается и редко меняется; постоянно меняющиеся данные дают низкий hit rate и много инвалидаций.
Cache-aside
В cache-aside (lazy loading) приложение само управляет кэшем: при чтении сначала смотрит кэш, при промахе читает БД, кладёт значение в кэш и возвращает. При записи кэш инвалидируют или обновляют.
Главный риск — рассинхронизация: между записью в БД и инвалидацией кэша возможно окно с устаревшими данными. TTL ограничивает длительность такой рассинхронизации.
User user = cache.get(id);
if (user == null) {            // cache miss
    user = repository.findById(id);
    cache.set(id, user, ttl);  // заполняем кэш
}
return user;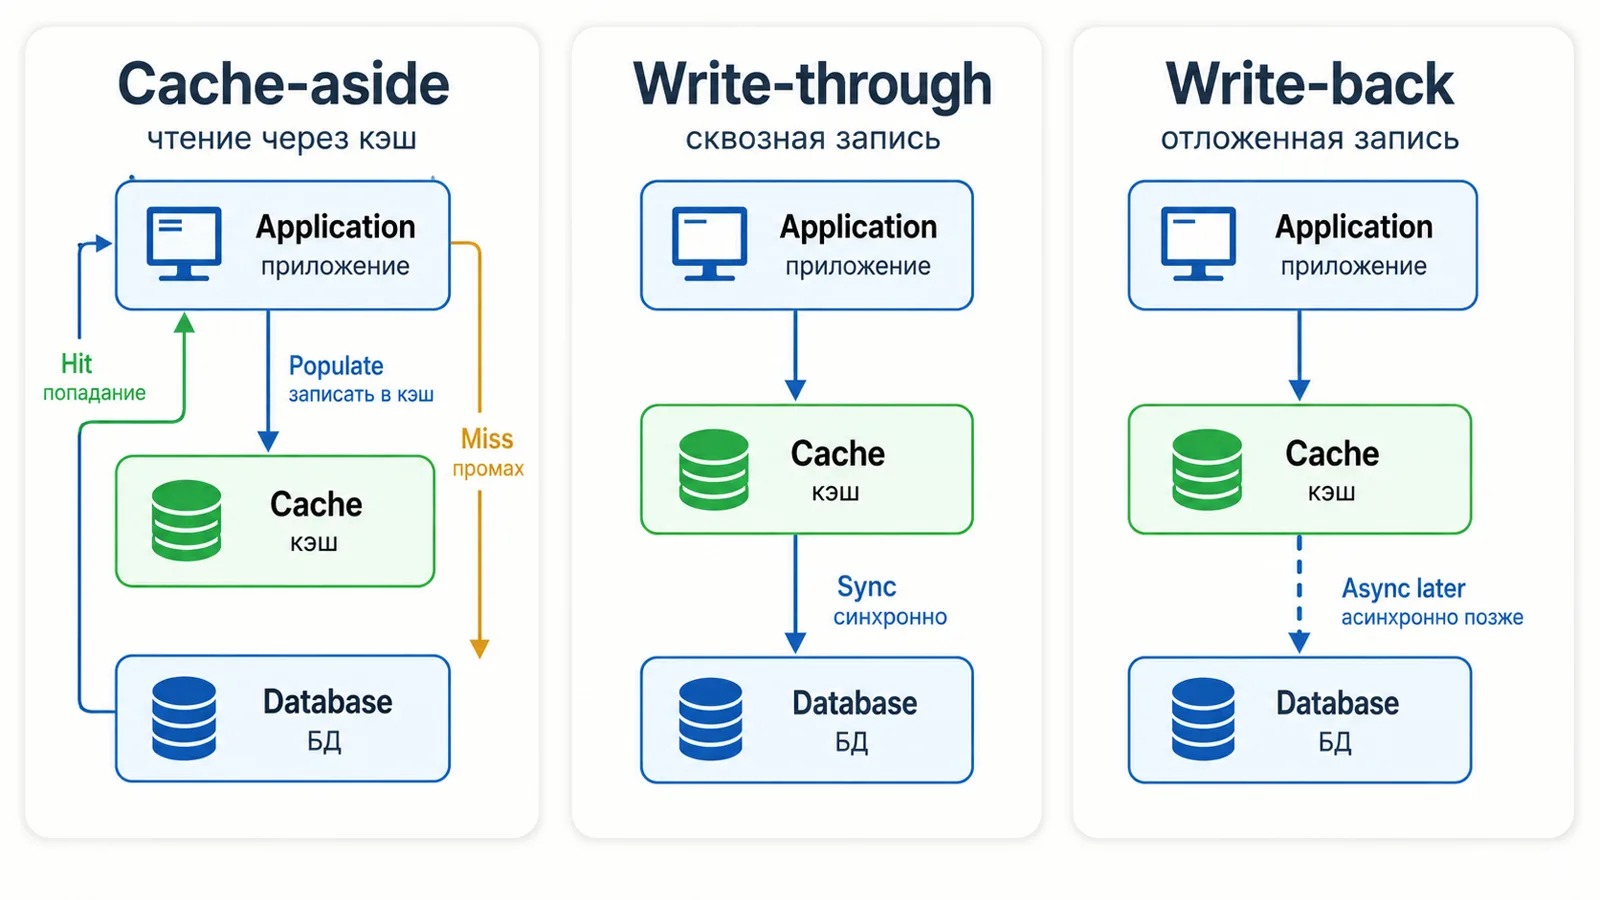
Стратегии записи и eviction
Кроме cache-aside есть write-through (пишем в кэш и БД синхронно — проще консистентность, дороже запись) и write-behind (пишем в кэш, в БД асинхронно — быстрее, но риск потери при сбое). Выбор зависит от требований к согласованности.
TTL даёт кэшу самовосстанавливаться. Eviction policy (LRU/LFU, allkeys/volatile) определяет, что Redis удалит при нехватке памяти — её подбирают под профиль доступа.
Cache stampede
Stampede (thundering herd) — когда популярный ключ истёк и множество запросов одновременно промахиваются и разом идут в БД, перегружая её. Особенно опасно при одинаковом TTL у тысяч горячих ключей.
Защита: добавить jitter к TTL (рандомизировать срок), single-flight/lock (пересчитывает один, остальные ждут или получают старое значение), stale-while-revalidate и прогрев горячих ключей.
Инвалидация: что именно ломается
«В программировании две сложные задачи: инвалидация кэша и придумывание имён» — шутка про реальную проблему. Разберём, откуда берётся рассинхронизация в cache-aside.
Порядок операций при записи важнее, чем кажется. Сначала обновить БД, потом удалить ключ — правильный порядок: окно рассинхронизации короткое, а при падении между шагами спасёт TTL. Обратный порядок (сначала удалить кэш, потом писать в БД) оставляет зазор, в который параллельный читатель успевает подтянуть из БД СТАРОЕ значение и снова положить его в кэш — теперь уже надолго.
Поэтому предпочитают удаление ключа, а не его обновление: два параллельных писателя могут положить свои значения в кэш в порядке, обратном порядку их коммитов в БД, и кэш «застынет» на устаревшем. Удаление такого эффекта не даёт — следующий читатель просто перечитает актуальное.
Отдельная ловушка — инвалидация до коммита транзакции: ключ удалён, а изменение ещё не видно другим, и читатель кладёт в кэш дореформенное значение. Инвалидировать надо ПОСЛЕ commit (в Spring это @TransactionalEventListener с фазой AFTER_COMMIT).
Плюс два системных решения на будущее: держать короткий TTL как страховку от любых пропущенных инвалидаций и версионировать ключи (user:42:v3), чтобы при смене формата данных не разгребать старьё, а просто перестать его читать.
Распределённые блокировки
Redis-lock делают через SET key token NX PX ttl: уникальный token и TTL обязательны, а снятие должно проверять token (через Lua/CAS), чтобы не снять чужую блокировку. TTL защищает от вечного lock при падении владельца.
Тонкость, ради которой нужен token: если владелец затормозил дольше TTL, блокировка уже перешла к другому, и простой DEL снимет ЧУЖУЮ — двое окажутся в критической секции одновременно. Сравнение token'а при снятии обязано быть атомарным, отсюда Lua-скрипт: проверка и удаление в одной операции.
И честная оговорка про границы: redis-lock не даёт гарантий при сетевых задержках, паузах GC и failover'е на реплику, где ключ мог не успеть реплицироваться. Для критичных финансовых инвариантов надёжнее транзакции БД (SELECT ... FOR UPDATE, unique-ограничение) или строгий координатор.
SET lock:order:42 <token> NX PX 30000   -- захват: только если ключа нет, с TTL

-- снятие: удалить, только если это НАША блокировка (атомарно, одним скриптом)
if redis.call('get', KEYS[1]) == ARGV[1] then
  return redis.call('del', KEYS[1])
else
  return 0
end
Как отвечать на собеседовании
Начните с рамки, которая задаёт весь ответ: кэш — это УСКОРЕНИЕ, а не источник истины. Его можно потерять целиком без потери данных, и приложение обязано это переживать. Дальше сразу критерий, что кэшировать: часто читается, редко меняется; постоянно меняющиеся данные дают низкий hit rate и бесконечные инвалидации.
Опишите cache-aside по шагам (читаем кэш → промах → читаем БД → кладём в кэш) и честно назовите его слабое место — окно рассинхронизации между записью в БД и инвалидацией, которое ограничивает TTL. Добавьте про порядок: сначала БД, потом удаление ключа, и только после commit.
Разведите стратегии записи одной фразой каждая: write-through — проще согласованность, дороже запись; write-behind — быстрее, но есть риск потери при сбое.
Stampede — вопрос, который любят: горячий ключ истёк, тысячи запросов одновременно промахнулись и разом пошли в БД. Назовите защиты: jitter к TTL, single-flight (пересчитывает один, остальные ждут), stale-while-revalidate, прогрев ключей.
Если дойдёт до распределённых блокировок, покажите, что знаете про token и атомарное снятие, и завершите зрелой оговоркой: там, где цена ошибки — деньги, полагаться стоит на транзакции БД, а не на lock в Redis.