 sotto
Что такое Stream
Stream — это не структура данных, а конвейер обработки последовательности элементов. Он не хранит элементы (тянет их из источника), не изменяет источник и одноразовый: после терминальной операции стрим использован, повторно по нему не пройти.
Идея — описать ЧТО сделать с данными декларативно (filter→map→collect), а не КАК итерировать вручную.
Источники
Стрим получают из коллекции (collection.stream(), parallelStream()), массива (Arrays.stream), явных значений (Stream.of), диапазона (IntStream.range), строк файла (Files.lines) и генераторов (Stream.iterate/generate — потенциально бесконечные).
Бесконечные источники безопасны только с обрывающими операциями (limit, findFirst) — иначе обработка не завершится.
Промежуточные против терминальных
Операции делятся на промежуточные (intermediate) — возвращают новый Stream и ленивы (map, filter, sorted, distinct, limit, peek) — и терминальные (terminal) — запускают обработку и дают результат/побочный эффект (collect, forEach, reduce, count, findFirst, anyMatch).
Без терминальной операции конвейер не выполнится вообще: цепочка map/filter без collect/forEach — это no-op. Ровно одна терминальная операция завершает стрим.
List<String> names = users.stream()
    .filter(User::isActive)  // ленивая (intermediate)
    .map(User::name)          // ленивая (intermediate)
    .toList();                // терминальная — здесь всё и считается
Ленивость и short-circuiting
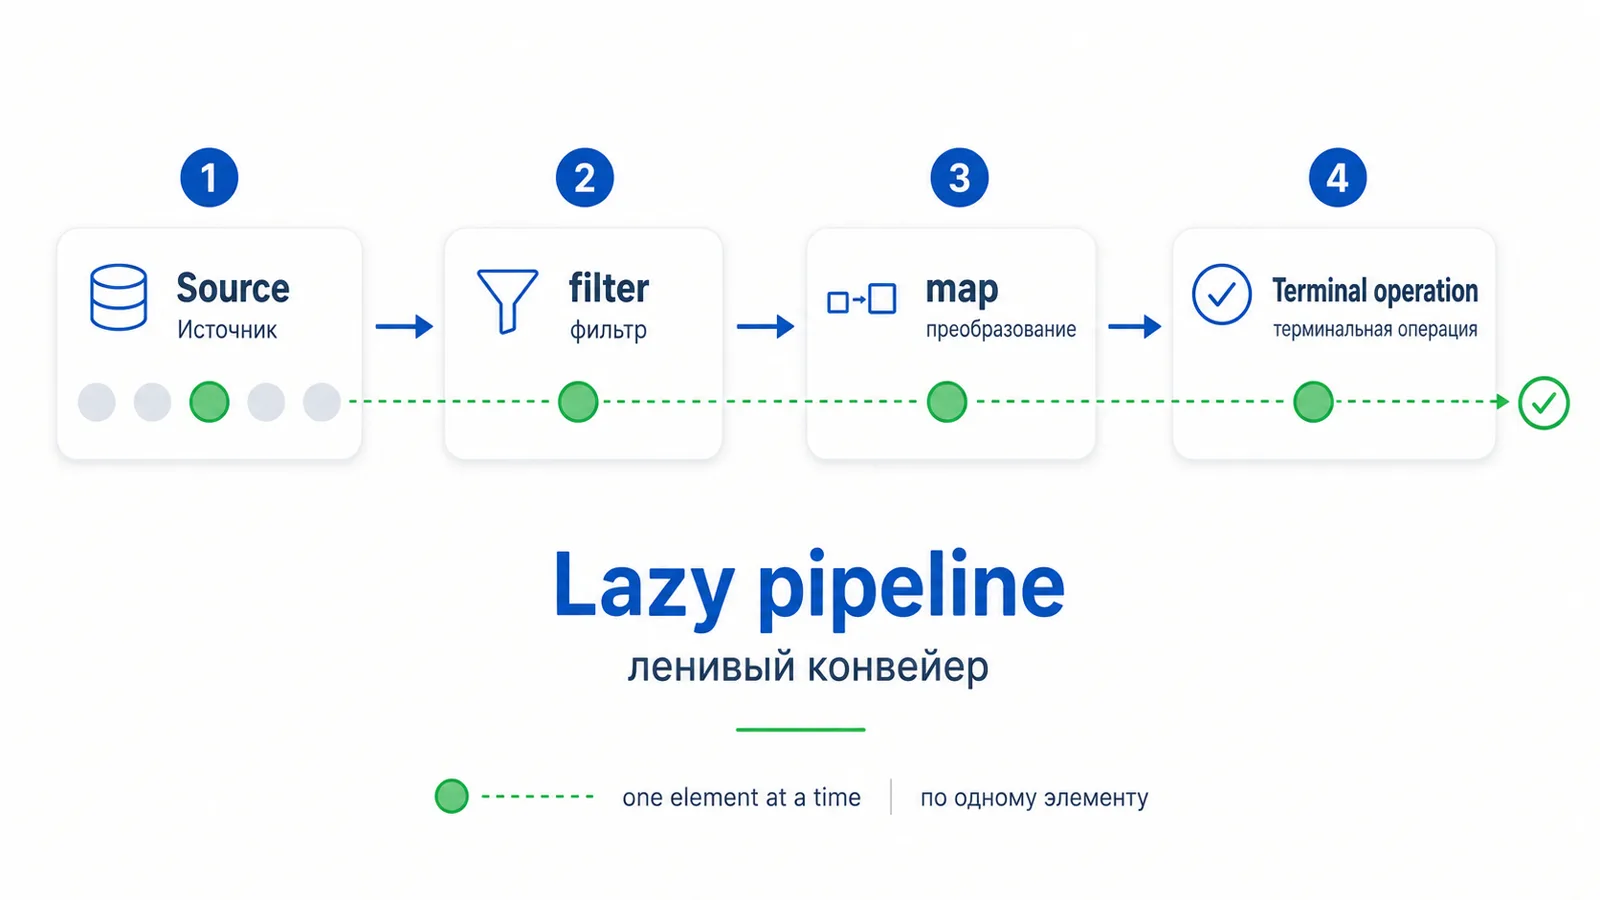
Конвейер обрабатывает элементы по одному сквозь все операции (а не «весь filter, потом весь map»). Эта ленивость даёт два эффекта: операции сливаются (fusion) в один проход, и обрывающие операции (findFirst, anyMatch, limit) останавливают обработку, как только результат ясен — остальные элементы не трогаются.
Поэтому users.stream().filter(...).findFirst() не фильтрует весь список, а останавливается на первом подходящем. peek помогает увидеть реальный порядок обработки при отладке.
Stateless, stateful и параллельность
Операции бывают stateless (map, filter — элемент обрабатывается независимо) и stateful (sorted, distinct, limit — требуют состояния/буфера или знания обо всём входе, поэтому могут «материализовать» поток). Стрим обычно сохраняет encounter order источника.
parallelStream() распараллеливает обработку на общем ForkJoinPool. Это выгодно лишь при большом объёме, дорогой на элемент работе и хорошо делимом источнике (ArrayList — да, LinkedList — плохо). Ловушки: побочные эффекты в лямбдах (гонки), затраты на разбиение/слияние, общий commonPool, неупорядоченность — поэтому параллелизм включают по замеру, а не по умолчанию.
Примитивные стримы
Stream<Integer> боксит каждый элемент. Для чисел есть IntStream/LongStream/DoubleStream без боксинга — с удобными sum(), average(), summaryStatistics().
Переходы между ними: mapToInt/mapToObj/boxed. В числовой обработке это и быстрее, и выразительнее (range, rangeClosed).
int total = orders.stream().mapToInt(Order::amount).sum(); // без боксингаКак отвечать на собеседовании
Скажите, что Stream — конвейер, не хранилище, одноразовый и не мутирует источник; разделите intermediate (ленивые) и terminal (запускает) и подчеркните, что без терминальной ничего не считается. Объясните ленивость + short-circuiting (один проход, findFirst/limit обрывают), stateful-операции и осознанный выбор parallel (объём/делимость/без side effects). Упомяните примитивные стримы против боксинга.