 sotto
Вертикально или горизонтально
Разговор о масштабировании начинается не с выбора между вертикальным и горизонтальным ростом, а с вопроса, какой ресурс заканчивается первым: процессор, память, диск, сеть, пул соединений или блокировки в базе. Пока ответа нет, любое решение — угадывание, и на собеседовании это видно сразу.
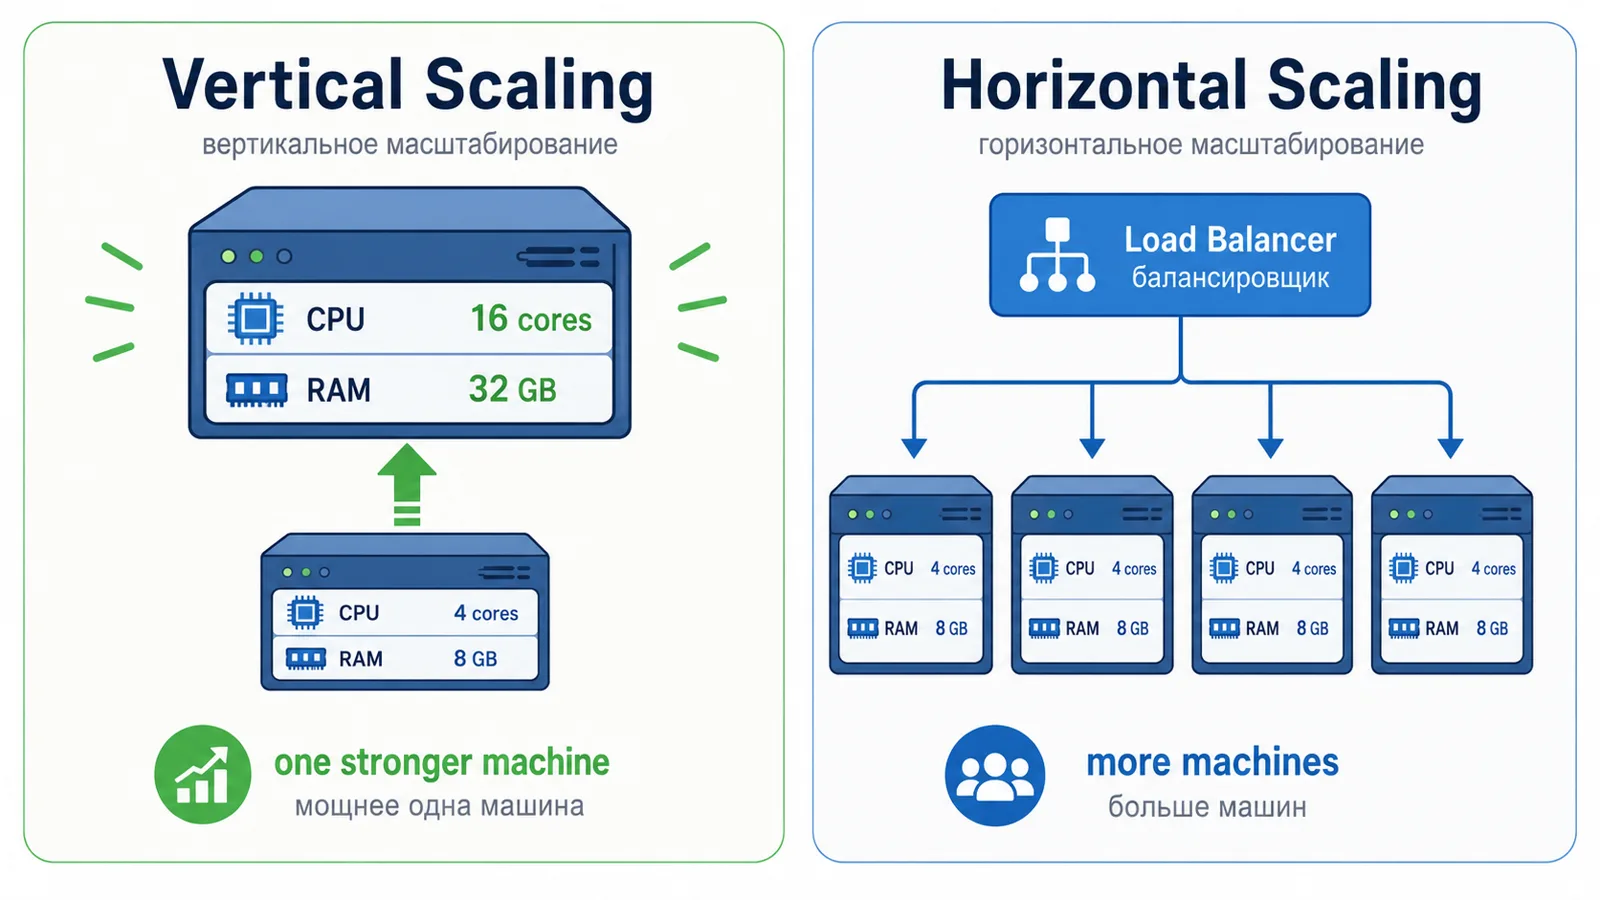
Вертикальное масштабирование — усилить одну машину: больше ядер, памяти, быстрее диски. Огромное преимущество в том, что архитектура не меняется: транзакции остаются локальными, согласованность бесплатна, отладка простая. Плата — потолок железа, нелинейная цена (топовая конфигурация стоит непропорционально дороже средней), простой на время апгрейда и сохранение единой точки отказа.
Горизонтальное масштабирование — добавлять машины и распределять нагрузку. Оно масштабируется дальше и переживает отказ узла, но покупается ценой распределённости: балансировка, отказ от локального состояния, частичные отказы, согласованность и координация. Всё, что в одной машине было бесплатно, здесь становится отдельной задачей.
На практике их сочетают, и разумный порядок обычно такой: сначала устранить очевидную неэффективность, потом вертикально усилить машину, потом делать сервис stateless и расти вширь, и только затем шардировать данные. Приложения без состояния растут горизонтально почти бесплатно, а состояние — дорого; поэтому основная архитектурная работа состоит в том, чтобы вынести состояние из приложения.
Полезно помнить, что горизонтальный рост не бесплатен даже для stateless-сервиса. Число соединений к базе умножается на число инстансов, и в какой-то момент добавление машин начинает ухудшать ситуацию: база тратит ресурсы на обслуживание соединений, а не на запросы. Именно поэтому между приложением и базой ставят пулер соединений, а не просто увеличивают количество инстансов.
Stateless и балансировка
Stateless-сервис не хранит между запросами ничего, что нельзя восстановить: сессии, счётчики, загруженные файлы, промежуточный прогресс выносятся в базу, распределённый кэш, объектное хранилище или брокер. Смысл не в чистоте идеи, а в свойстве: любой инстанс может обслужить любой запрос, любой инстанс можно погасить и добавить без потерь. Именно это делает возможными выкатку, автоскейл и переживание отказа узла.
Привязка клиента к инстансу (sticky sessions по куке или по адресу) позволяет жить с состоянием в памяти, но это компромисс, а не решение: нагрузка распределяется неравномерно, при выкатке или падении инстанса сессия теряется, автоскейл работает хуже. Как оптимизация локального кэша привязка полезна, как фундамент архитектуры — нет.
Балансировщики работают на двух уровнях. На четвёртом (TCP) они дёшевы, быстры и ничего не знают о содержимом запроса. На седьмом (HTTP) они понимают пути и заголовки, умеют маршрутизировать по версии, взвешивать трафик для канареечной выкатки, ограничивать частоту запросов и повторять неудачные — платой становятся задержка и стоимость. Алгоритм выбирают по характеру нагрузки: round-robin для одинаковых инстансов и коротких запросов, least-connections при разнородной длительности, хеш по ключу — когда важна локальность кэша.
Здоровье инстансов проверяют двумя разными пробами, и путать их — частая ошибка. Проба живости отвечает на вопрос, нужно ли перезапустить процесс; проба готовности — можно ли слать на него трафик прямо сейчас. Инстанс, прогревающий пулы и кэши, жив, но не готов, и балансировщик не должен на него нагружать. Отдельно обязателен корректный останов: инстанс сначала перестаёт проходить пробу готовности, дожидается завершения текущих запросов и только потом умирает — иначе каждая выкатка теряет часть трафика.
Сам балансировщик не должен становиться единой точкой отказа: его резервируют несколькими узлами и распределяют трафик через DNS или anycast. И у него есть свои пределы — число одновременных соединений и пропускная способность, — про которые вспоминают редко, обычно уже во время инцидента.
Шардинг и consistent hashing
Когда упирается уже не приложение, а база на запись, данные разрезают на шарды. Схем разбиения три. По диапазону ключа — удобны диапазонные запросы, но легко получить горячий шард, если ключ монотонный: все свежие записи идут в один диапазон. По хешу — распределение равномерное, но диапазонные запросы разъезжаются по всем шардам. Через справочник соответствия — гибко и позволяет переносить отдельных клиентов, но сам справочник нужно хранить, кэшировать и защищать от превращения в узкое место.
Ключ шардирования — главное решение, и менять его потом очень дорого. Хороший ключ одновременно даёт равномерное распределение и собирает вместе данные, которые читаются вместе. Если типичный запрос вынужден обходить все шарды и собирать результат, задержка определяется самым медленным шардом, а с ростом их числа растёт и вероятность, что какой-то из них тормозит.
Наивное распределение по остатку от деления хеша на число узлов плохо переносит изменение этого числа: при добавлении одного узла переезжает почти всё. Consistent hashing размещает узлы и ключи на кольце, и при добавлении или удалении узла переезжает только доля ключей, обратно пропорциональная числу узлов. Чтобы распределение было ровным, каждый физический узел представляют десятками виртуальных точек на кольце — иначе разброс нагрузки между узлами получается заметным.
Цену шардинга нужно называть честно: исчезают межшардовые джойны и транзакции, глобальная уникальность и автоинкремент требуют отдельного решения (идентификаторы вроде UUID или snowflake), а перешардирование превращается в операционный проект с двойной записью и переносом данных под нагрузкой. Поэтому шардинг — последнее средство, к которому приходят после кэша, реплик на чтение, архивации холодных данных и вертикального роста базы.
Отдельный сюжет — перекос. Даже при равномерном хешировании несколько крупных клиентов могут давать основную часть нагрузки и класть её на один шард. Лечится это составным ключом (клиент плюс что-то более гранулярное), выделением тяжёлых клиентов на отдельные шарды или подшардированием их данных. Симптом простой: утилизация одного шарда сильно выше остальных, и добавление шардов ничего не меняет.
Реплики на чтение и репликационный лаг
Нагрузку, где чтений на порядок больше записей, масштабируют репликами: запись идёт на лидера, чтение расходится по репликам. Это простой и дешёвый шаг, который часто откладывает шардинг на годы. Но реплики не масштабируют запись — каждая реплика применяет тот же поток изменений, что и лидер, поэтому в системе с преобладанием записи они только добавляют работы. Предложить реплики в ответ на проблему с записью — заметная ошибка на собеседовании.
Репликационный лаг — не аномалия, а нормальный режим асинхронной репликации: лидер подтверждает запись, не дожидаясь применения на репликах. Лаг растёт при массовых обновлениях, долгих транзакциях и перестроении индексов, и измерять его нужно во времени, а не в байтах отставания — только время говорит, насколько устарели данные, которые видит пользователь.
Следствие лага — пользователь может не увидеть собственную запись сразу после сохранения. Гарантию чтения своих записей строят несколькими способами: отправлять чтения этого пользователя на лидера в течение нескольких секунд после его записи, передавать позицию журнала вместе с запросом и ждать, пока реплика её догонит, или закладывать оптимистичное обновление в интерфейсе. Выбор зависит от того, насколько дорого лишний трафик на лидера.
Синхронная или полусинхронная репликация убирает лаг для подтверждённых записей, но перекладывает цену на задержку записи и на доступность: если реплика недоступна, запись останавливается. Это ровно тот компромисс между задержкой и согласованностью, который описывает PACELC, и его стоит называть вслух.
Практическая деталь, о которой часто забывают: маршрутизация чтений на реплики должна быть осознанной, а не автоматической для всего подряд. Отчёты, аналитика и экспорт — идеальные кандидаты; проверка баланса перед списанием — нет. Разделяйте чтения по требованию к свежести, а не по удобству кода.
Автоскейл и его ловушки
Автоскейл добавляет и снимает инстансы по сигналу нагрузки. Выбор сигнала важнее самого механизма: загрузка процессора годится для вычислительных сервисов, а для сервисов, ждущих ввод-вывод, она вводит в заблуждение — там честнее скейлиться по числу запросов, по задержке или по глубине очереди. Для потребителей брокера правильный сигнал почти всегда один — отставание в разделах.
Без гистерезиса и паузы после изменения скейлер начинает дёргать количество инстансов туда-сюда на каждом всплеске, а каждый цикл стоит запусков и прогревов. Порог на увеличение и порог на уменьшение делают разными, а уменьшение — более медленным и осторожным: ошибиться в сторону лишнего инстанса дешевле, чем снять нужный.
Холодный старт — главная причина, по которой автоскейл не спасает от резкого всплеска. Свежий инстанс должен прогреть пулы соединений, кэши и код (для JVM — дождаться компиляции горячих участков), и до этого момента отвечает медленнее, а иногда и хуже, чем никак. Проба готовности обязана это отражать, а под предсказуемые пики лучше работает расписание или прогноз, а не реакция по факту.
Самая опасная ловушка в том, что автоскейл верхнего слоя способен добить нижний. Больше инстансов — больше соединений к базе, больше запросов к внешнему API с квотой, больше конкуренции за общий ресурс. Поэтому у автоскейла обязателен потолок, а у нижних слоёв — своя защита: ограничение пула на инстанс, лимиты частоты запросов, очередь. Автоскейл масштабирует только то, что действительно масштабируется горизонтально.
Где настоящее узкое место
Самая частая ошибка масштабирования — увеличивать то, что не является ограничением. Добавление инстансов приложения не поможет, если каждая операция проходит через один глобальный счётчик, общую блокировку или единственного лидера базы: последовательная часть работы остаётся последовательной, сколько машин ни поставьте.
Это формулируется и количественно. Если часть работы не распараллеливается, она задаёт потолок ускорения; а если узлы вдобавок координируются между собой, то после определённого числа узлов производительность начинает падать — стоимость согласования растёт быстрее выигрыша. Практический вывод один: сначала сокращают последовательную часть и координацию, потом добавляют мощность.
Искать ограничение нужно по данным, а не по интуиции: где проведено время запроса (процессор приложения, ожидание базы, внешние вызовы), какие пулы и очереди насыщены, какова утилизация конкретного ресурса. Насыщение информативнее утилизации: полностью занятый пул соединений при тридцати процентах загрузки процессора — исчерпывающий диагноз, и добавление машин его только ухудшит.
Стоит помнить и о том, что деградация под нагрузкой нелинейна. По мере приближения утилизации к ста процентам время ожидания в очереди растёт стремительно, поэтому системы держат с запасом, а не на пределе: сервис, работающий на девяноста процентах, отвечает на небольшой всплеск непропорционально большой задержкой.
И самый недооценённый вариант ответа: часто масштабировать не нужно вовсе. Убрать запрос в цикле, добавить недостающий индекс, включить пакетную обработку, закэшировать тяжёлый расчёт — такие изменения дают выигрыш в разы или на порядки и не добавляют ни одной новой машины и ни одной новой проблемы.
Как отвечать на собеседовании
Не начинайте с решения. Начните с вопроса, что именно упирается и в каких числах: сколько запросов в секунду, каково соотношение чтения и записи, где проведено время запроса. Ответ «добавим инстансов» без этого разбора звучит как заученный, а разбор сразу выделяет опытного инженера.
Держите в голове порядок шагов и проговаривайте его: устранить очевидную неэффективность, вырасти вертикально, сделать сервис stateless и вырасти горизонтально, добавить реплики на чтение, и только потом шардировать. Такой порядок показывает, что вы понимаете стоимость каждого шага, а не просто знаете слова.
Каждый выбранный шаг называйте вместе с его ценой: реплики дают лаг и не помогают записи, шардинг убирает джойны и транзакции и требует выбора ключа, автоскейл упирается в холодный старт и способен добить базу, привязка сессий ломает выкатку. Именно перечисление цены отличает ответ уровня senior.
Заканчивайте проверкой: по каким метрикам будет видно, что стало лучше. Задержка на девяносто девятом перцентиле, насыщение пулов, лаг реплик, распределение нагрузки по шардам. Решение без способа убедиться в его пользе — это гипотеза, а не инженерия.