 sotto
Распределённый append-only лог
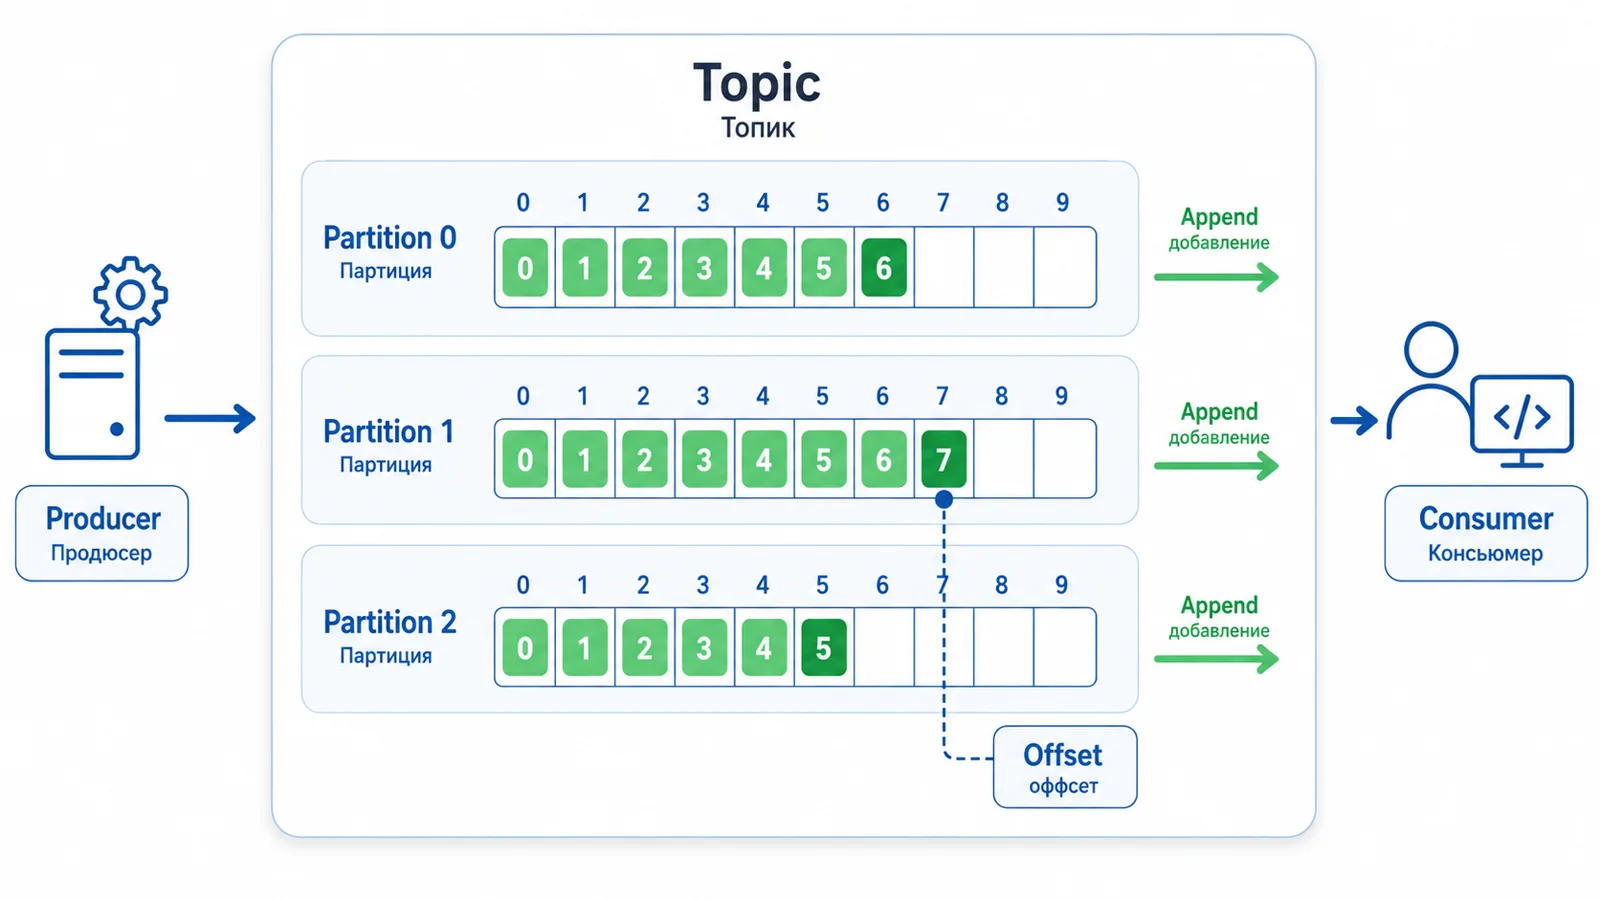
Концептуально Kafka — это не классическая очередь, а РЕПЛИЦИРОВАННЫЙ append-only лог. Сообщения пишутся в topic, topic делится на partitions, каждая партиция — упорядоченный лог на диске, а consumer читает с конкретного offset (порядковый номер записи в партиции).
Offset уникален ТОЛЬКО внутри одной партиции — глобального offset «на весь topic» не существует. Поэтому большинство гарантий и характеристик Kafka формулируются именно в терминах партиции, а не темы целиком.
Партиция — единица всего
Партиция — единица сразу нескольких вещей. Единица распределения: партиции разъезжаются по брокерам кластера. Единица репликации: у каждой партиции есть leader и followers с фактором replication factor. Единица упорядоченности: порядок есть только внутри одной партиции.
Главное практическое следствие — параллелизм consumer group ограничен ЧИСЛОМ партиций. Если в группе consumer'ов больше, чем партиций, лишние будут простаивать без работы. Поэтому число партиций — главный параметр пропускной способности группы.
Ключ и порядок
Порядок гарантируется внутри партиции. Чтобы события одного бизнес-агрегата шли последовательно, им задают одинаковый key — дефолтный partitioner кладёт их в одну и ту же партицию: hash(key) % numPartitions.
Ловушка: если потом увеличить число партиций, формула партиции по ключу поменяется, и НОВЫЕ сообщения того же ключа могут попасть в другую партицию (старые останутся в прежней). Это может разорвать порядок по ключу. Поэтому число партиций планируют заранее с запасом — лишние партиции дёшевы, а изменить их позже — больно.
Retention: time и size
Kafka хранит данные по политике retention. Чаще всего — по времени (retention.ms, по умолчанию ~7 дней) или по размеру (retention.bytes). Можно объединять — что наступит раньше, то и сработает.
Удаление работает СЕГМЕНТАМИ файлов лога, а не отдельными сообщениями: Kafka закрывает заполнившийся сегмент и периодически удаляет целые старые сегменты. Отсюда дешёвые крупноблочные операции и невозможность «удалить одно конкретное сообщение».
Log compaction
Альтернативный режим retention для key-value тем — log compaction: для каждого ключа Kafka хранит только ПОСЛЕДНЕЕ значение, более старые версии этого ключа удаляются при компакции. Запись с null-значением (tombstone) удаляет ключ полностью.
Это превращает compacted topic в распределённый снимок состояния: чтение с начала восстанавливает текущую картину по ключам. Используется для конфигурационных тем, текущих состояний агрегатов и Kafka Streams state stores.
Replay и offset reset
Поскольку лог хранится, можно перечитать любой диапазон: по offset или по времени (offsetsForTimes). Это даёт replay — мощный инструмент для пересборки состояния consumer'а, миграции, дебага и появления новых подписчиков на исторические данные.
У consumer'а без сохранённого offset поведение задаёт auto.offset.reset: earliest (с начала лога — для bootstrap новой группы), latest (только новые сообщения), none (бросить ошибку). Выбор — это уже про намерение: догнать историю или подключиться «с момента запуска».
Как отвечать на собеседовании
Опишите Kafka как распределённый append-only лог: topic → partitions → offset (offset только в партиции). Подчеркните роль партиции как единицы распределения/репликации/порядка и связку «параллелизм группы ≤ число партиций». Объясните ключ и hash-партиционирование, и ловушку добавления партиций (распределение по ключу меняется → возможный разрыв порядка). Различите time/size retention и log compaction (последнее значение по ключу + tombstone). Назовите replay и auto.offset.reset как основу пересборки состояния.