 sotto
Consumer group и assignment
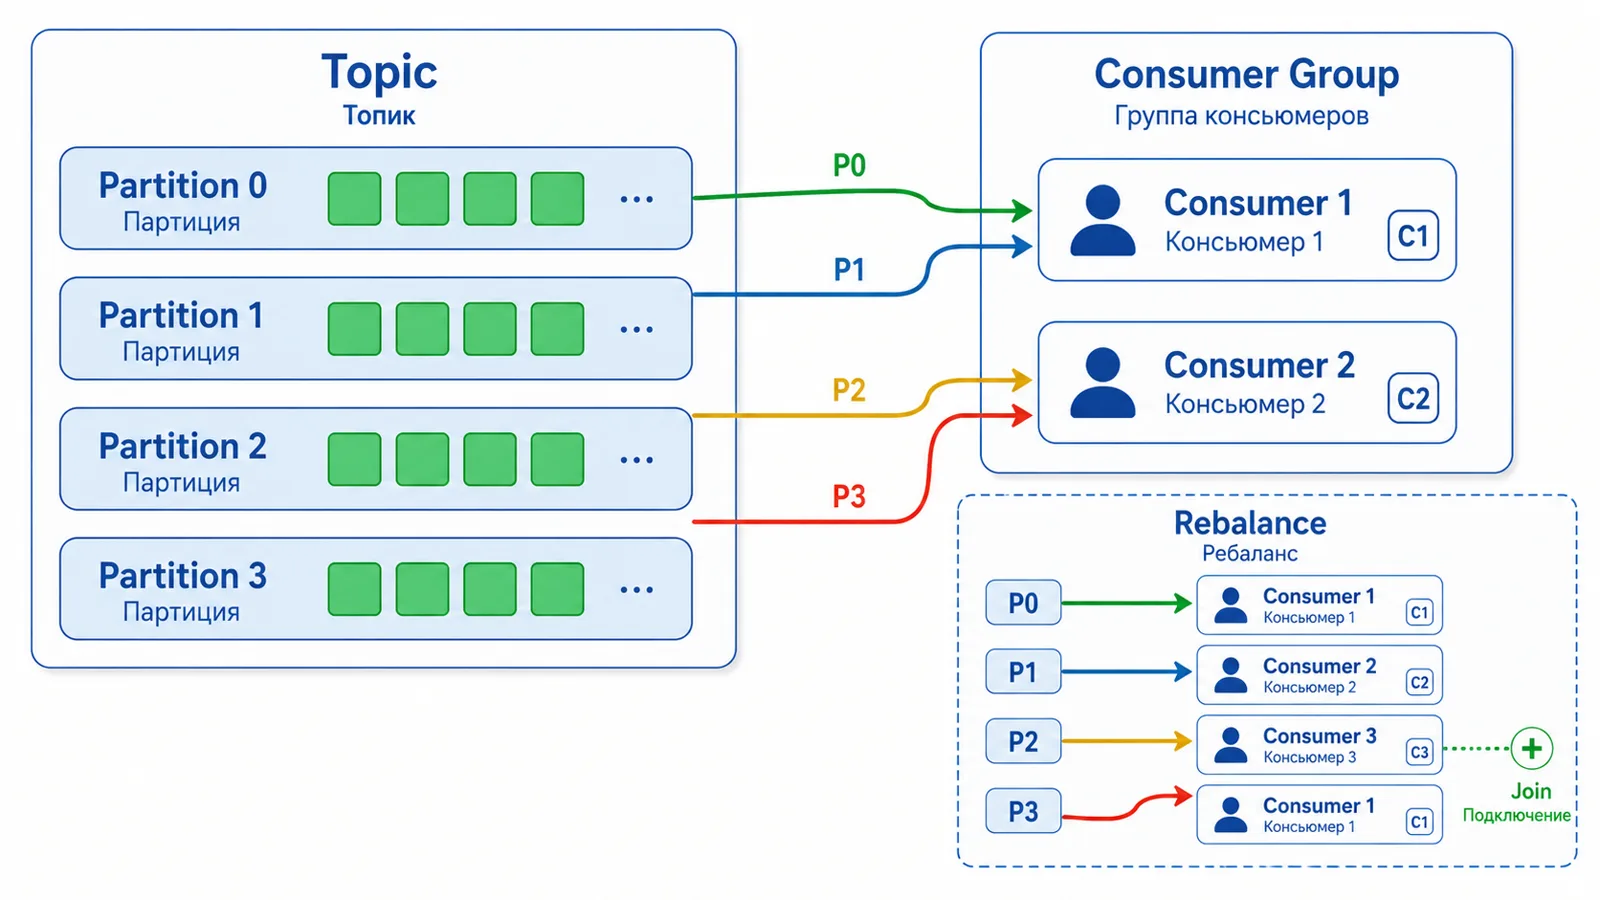
group.id задаёт логического подписчика. Брокер распределяет партиции темы между consumer'ами группы (assignment): в каждый момент одна партиция принадлежит ровно одному consumer'у группы. Так одна группа = work queue, разные группы = независимые pub/sub-потоки поверх того же лога.
Стратегия распределения настраивается: range и round-robin — классические; sticky и особенно cooperative-sticky стараются МИНИМИЗИРОВАТЬ движение партиций при ребалансе (важно для горячих кэшей). Если consumer'ов в группе больше, чем партиций, лишние простаивают без работы.
Poll loop
Kafka — pull-модель: consumer сам ходит к брокеру через consumer.poll(timeout). Тот возвращает батч записей, consumer обрабатывает их и коммитит offset, после чего следующий poll(). Это единственный «нормальный» цикл — обработка и коммит в нём же.
Размером батча и поведением ожидания управляют параметры: max.poll.records (макс записей за один poll), fetch.min.bytes и fetch.max.wait.ms (брокер может подержать запрос, чтобы собрать больше данных — батчинг и на стороне брокера). Тяжёлый serializer/десериализация добавляют латентность каждого poll.
Heartbeat и обнаружение смерти
У consumer есть отдельный heartbeat-thread, который отправляет брокеру сигналы жизни. session.timeout.ms задаёт, через сколько без heartbeat consumer'а сочтут мёртвым и запустят rebalance.
Отдельно — max.poll.interval.ms: МАКСИМУМ между двумя poll(). Если обработка батча затянулась дольше, брокер считает consumer'а зависшим (даже если heartbeat шёл) и выгоняет его из группы. Отсюда правило: тяжёлую обработку либо ускоряют, либо повышают max.poll.interval.ms, либо выносят в отдельные воркеры, а consumer только декодирует и распределяет.
Модели commit offset
Способов фиксировать прогресс несколько. enable.auto.commit=true (фоновый авто-commit каждые auto.commit.interval.ms) проще, но опасен: легко закоммитить ДО обработки и потерять сообщения при падении. Для прода обычно отключают и коммитят руками.
Ручной commit: commitSync() — блокирующий и надёжный (повторяет ретраиваемые ошибки), commitAsync() — быстрее, но без гарантий. Практичный паттерн — обработать батч → commitSync после успеха (at-least-once + идемпотентность обработки). Чем коммитят: offset, который указывает на СЛЕДУЮЩЕЕ сообщение, а не последнее обработанное (классическая ошибка off-by-one).
Ребаланс
Ребаланс — перераспределение партиций между членами группы — случается при подключении/уходе consumer'а, изменении подписки или числа партиций. В классическом «eager» протоколе вся группа на короткое время ОСТАНАВЛИВАЕТСЯ (stop-the-world): все возвращают свои партиции, потом получают новые.
Cooperative rebalance (Kafka 2.4+, cooperative-sticky) делает то же ИНКРЕМЕНТАЛЬНО — двигаются только нужные партиции, остальные продолжают работу. Для cleanup и сохранения локального состояния перед сменой партиции вешают ConsumerRebalanceListener (commit, очистка кэша).
В Kafka 4.0 появился новый протокол групп (KIP-848, group.protocol=consumer): распределение партиций считает уже не лидер группы на клиенте, а координатор на брокере, и ребаланс идёт инкрементально по умолчанию — без остановки всей группы.
At-least-once и идемпотентность
Практический дефолт обработки — at-least-once: получили батч → обработали с побочным эффектом → закоммитили offset. Если упасть между обработкой и commit, при следующем запуске сообщение придёт повторно — отсюда требование к ИДЕМПОТЕНТНОЙ обработке (см. урок про основы).
Альтернатива — commit ДО обработки (at-most-once): дублей не будет, но при сбое сообщение потеряется. Для большинства бизнес-сценариев это неприемлемо, поэтому при-обработке-потом-commit + идемпотентность — устоявшаяся практика.
Как отвечать на собеседовании
Разберите группу и assignment (range/round-robin/sticky/cooperative-sticky; consumer ≤ партиций по полезной работе). Объясните pull-poll-цикл и его параметры (max.poll.records, fetch.min.bytes). Разделите session.timeout.ms (heartbeat) и max.poll.interval.ms (тяжёлая обработка → eviction). Сравните commit-модели (auto-commit опасен; ручной sync после успеха — дефолт) и порядок rebalance (eager STW vs cooperative-sticky без полного STW). Завершите тезисом at-least-once + идемпотентность как практическим стандартом.