 sotto
Что повторять, а что нет
Ретраи помогают только при ВРЕМЕННЫХ (transient) ошибках: сетевой сбой, таймаут, 5xx от зависимости, временная блокировка БД. Постоянные ошибки — валидация, формат, бизнес-правило — повторами не лечатся: повторите — снова упадёт.
Поэтому код различает категории ошибок и ретраит только transient. Permanent-ошибки сразу уходят в DLQ или возвращаются вызывающему. Бесконечные слепые ретраи на любую ошибку — почти всегда симптом плохого дизайна.
Backoff и jitter
Между попытками обязательны экспоненциальный backoff (1с → 2с → 4с) и случайный jitter — добавка, разводящая ретраи во времени. Без jitter тысячи клиентов синхронно повторят запрос через одну и ту же паузу и добьют уже шатающуюся зависимость (retry storm / thundering herd).
У ретраев всегда есть лимит попыток. И есть тонкость в брокерах: если consumer ретраит в том же потоке (blocking retry), он удерживает offset и блокирует всю партицию — лаг растёт, остальные сообщения ждут. Поэтому для брокерных consumer'ов чаще применяют non-blocking retry.
Non-blocking retry
Идея: при ошибке не ретраить на месте, а ПЕРЕНАПРАВИТЬ сообщение в отдельный retry-топик с задержкой (orders.retry-5s, orders.retry-30s, orders.retry-5m). Отдельный consumer этого топика ждёт паузу и пытается снова на основном. Так основной поток партиции не блокируется одной плохой записью.
В Spring Kafka это реализует @RetryableTopic — фреймворк сам создаёт retry-топики по уровням и DLT после исчерпания лимита. Цена — больше топиков и сложнее наблюдение, но партиция не стоит из-за одного poison-сообщения.
Дизайн DLQ
DLQ (Dead Letter Queue/Topic) хранит то, что не удалось обработать после исчерпания ретраев или из-за невосстановимой ошибки. В Kafka это отдельный топик, в RabbitMQ — очередь, связанная с DLX (Dead Letter Exchange).
Хорошая DLQ-запись несёт: оригинальный payload без модификации, причину (заголовки error.class, error.message, stacktrace), originating-topic/partition/offset и correlation id для трассировки. Без этого в DLQ остаётся непригодный для разбора мусор.
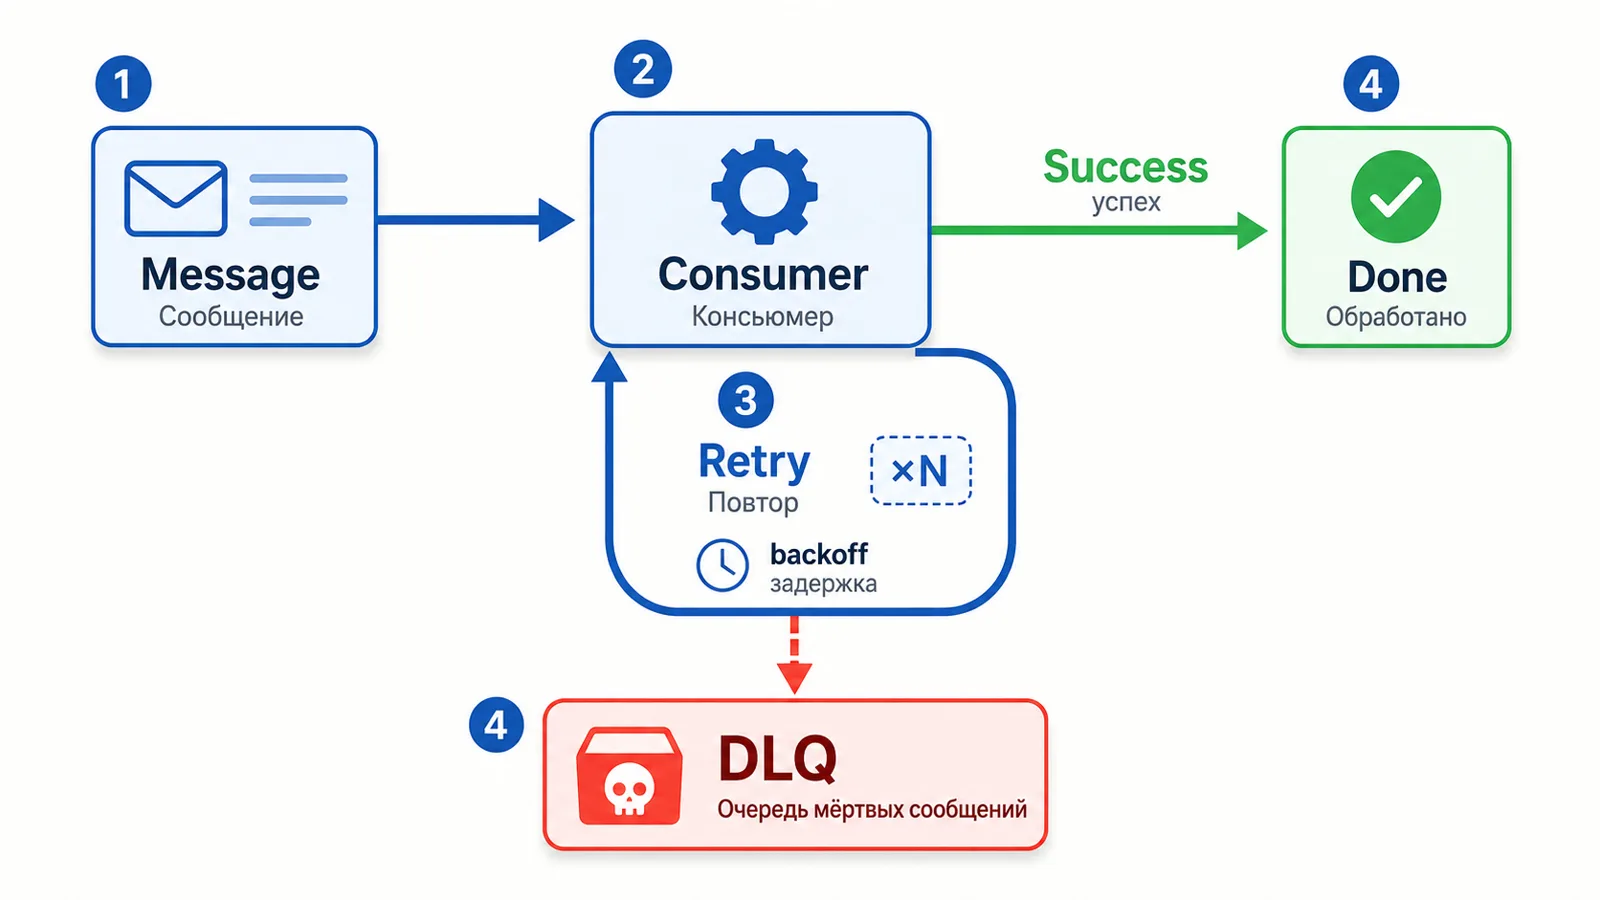
Redrive и владелец
У DLQ ОБЯЗАТЕЛЬНО должен быть владелец (команда/сервис), процедура разбора и инструмент redrive — возврата сообщений в основной поток после исправления первопричины. Без этого DLQ превращается в свалку, в которую тихо сваливаются события, которые «как будто обработали».
Минимум для прода: алерт на любое сообщение в DLQ (или на скорость поступления), runbook разбора, скрипт/команда redrive с учётом идемпотентности consumer'а. Метрика «count in DLQ» должна стремиться к нулю.
Идемпотентность как фундамент
At-least-once + ретраи + ребалансы = неминуемые дубли. Поэтому consumer ОБЯЗАН обрабатывать одно сообщение повторно с тем же эффектом, что и в первый раз — без двойного списания, двойного письма, двойной строки в БД.
Практика: в сообщение кладут стабильный idempotency key (event_id), а consumer держит таблицу processed_events с unique-constraint по нему и пишет бизнес-эффект + отметку об обработке в ОДНОЙ транзакции. Альтернативы — upsert/CAS по версии агрегата, дедупликация по натуральному ключу.
-- атомарно: либо и эффект, и отметка, либо ничего
begin;
  insert into processed_events(event_id) values (?) on conflict do nothing returning event_id;
  -- если returning пуст — событие уже было обработано, выходим
  update accounts set balance = balance + ? where id = ?;
commit;
Как отвечать на собеседовании
Разделите transient vs permanent ошибки и подчеркните: ретраить только transient, остальное — в DLQ. Назовите обязательные backoff + jitter (против retry storm) и риск blocking retry в брокерах (блокирует партицию) → паттерн non-blocking retry через retry-топики. Опишите хорошую DLQ-запись (payload + причина + контекст), требование владельца и redrive-процедуры. Завершите тезисом: at-least-once → идемпотентность consumer'а через idempotency key и атомарную запись эффекта+отметки.