 sotto
Почему не 2PC
Один бизнес-процесс часто пересекает границы нескольких сервисов и БД (оформить заказ = списать деньги + зарезервировать склад + создать доставку). Соблазн — обернуть всё в одну распределённую транзакцию через 2PC; но 2PC хрупок: блокирует ресурсы у всех участников до коммита, плохо переживает сбои координатора и сильно бьёт по доступности.
В микросервисах от 2PC отказываются. Вместо него процесс собирают из ЛОКАЛЬНЫХ транзакций каждого сервиса, соединённых асинхронными сообщениями. Это и есть сага.
Сага и компенсации
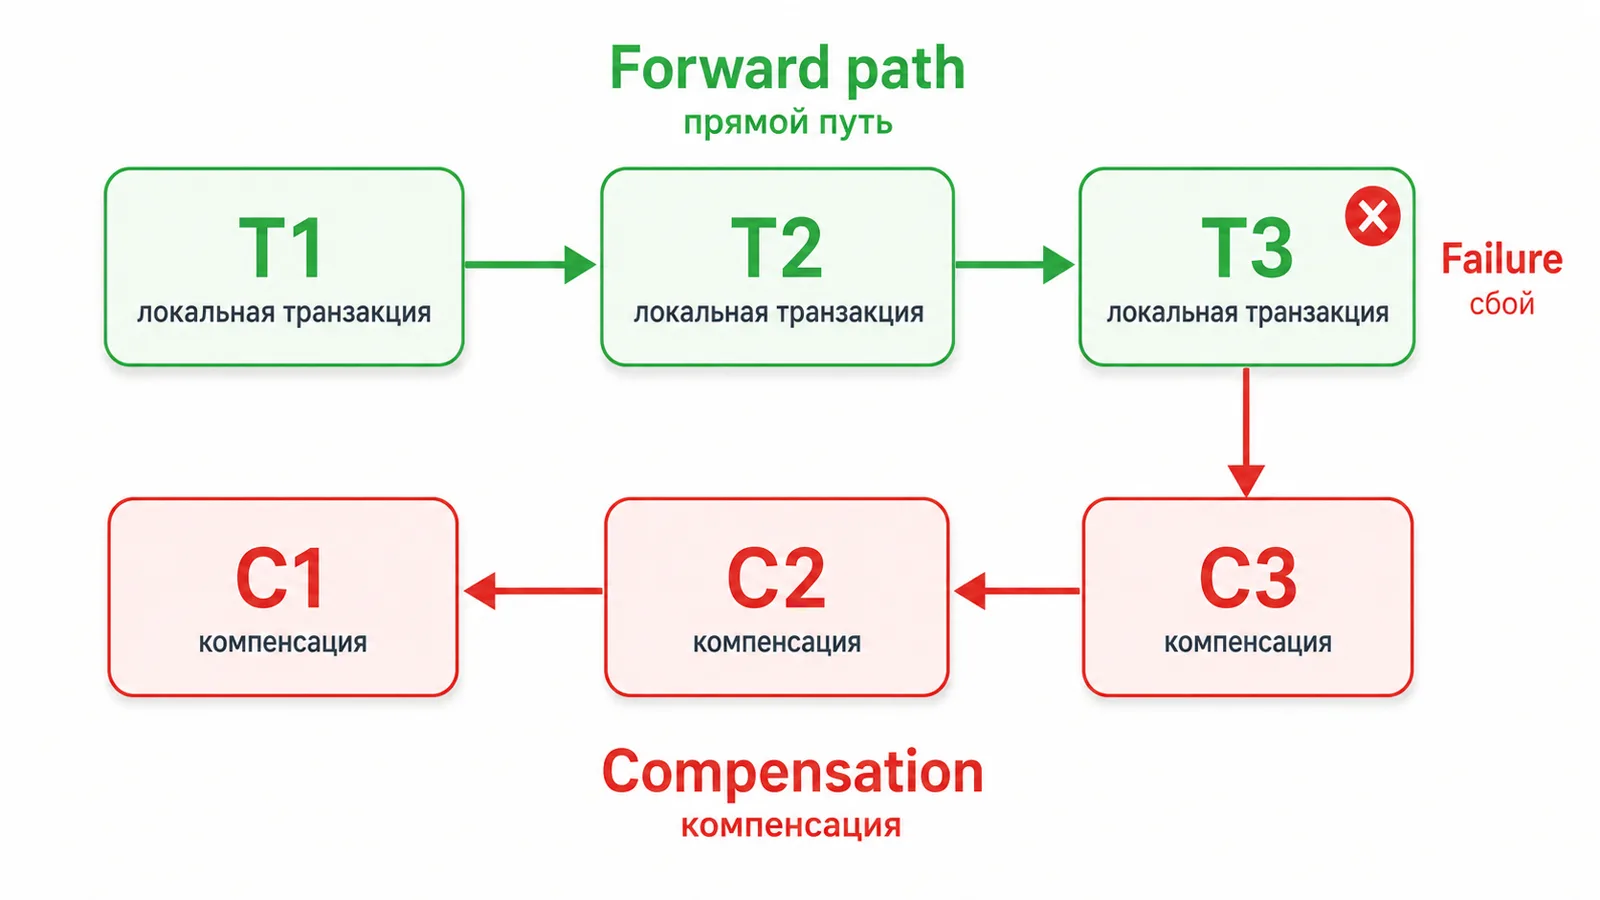
Сага — последовательность локальных транзакций. Каждый шаг успешно коммитится в своём сервисе, после чего публикует событие, на которое реагирует следующий шаг. Если какой-то шаг провалился, запускаются КОМПЕНСИРУЮЩИЕ действия для уже совершённых.
Ключевая идея: компенсация — не «технический rollback», а БИЗНЕС-обратное действие. Списали деньги → возврат на счёт; забронировали склад → освободили резерв; отправили письмо «вы оформили заказ» → отправляют «извините, заказ отменён». Не всё бывает компенсируемым (отправленный физический товар — компенсация это return); компенсации тоже должны быть идемпотентными.
Хореография
Хореография строится только на событиях: сервис A в своей транзакции публикует OrderCreated, сервис B видит его и публикует PaymentAuthorized, сервис C видит то и публикует ShipmentRequested. Никакого центрального управляющего — каждый знает только своих соседей по событиям.
Плюсы: низкая связность, легко добавлять новых подписчиков. Минусы: общий процесс размазан по сервисам — сложно ответить «на каком этапе сейчас заказ» и тяжелее отлаживать. Подходит для простых цепочек.
Оркестрация
Оркестрация ставит центральный координатор (saga manager / process manager), который явно держит state machine процесса и шлёт команды участникам: «спишите деньги», «зарезервируйте склад», «оформите доставку». Те отвечают результатами; при отказе оркестратор сам запускает компенсации в обратном порядке.
Плюсы: процесс виден целиком, его легко наблюдать и тестировать; явные таймауты и ретраи на каждом шаге. Минусы: координатор становится критичным компонентом, и появляется логика «оркестратора», которой надо управлять. Выбор: простые цепочки → хореография; длинные процессы с откатами и таймаутами → оркестрация.
CDC: как устроен
Change Data Capture не polling таблицы и не триггеры — это ИНКРЕМЕНТАЛЬНОЕ чтение журнала БД (WAL у PostgreSQL, binlog у MySQL): каждое изменение строки оттуда вычитывается и публикуется как событие. Это дёшево для БД и не теряет изменений.
Самая распространённая реализация — Debezium как Kafka Connect source. Применения: репликация данных в поисковые/аналитические системы, синхронизация кэшей, миграции между БД, и — главный паттерн — outbox relay.
CDC vs доменные события
Прямой CDC выдаёт «row changed» — техническое событие на уровне строки. Доменное событие («OrderPaid») — другая абстракция: с бизнес-смыслом, версионируемое, иногда агрегирующее несколько строк.
Поэтому сырой CDC опасно выпускать наружу как контракт — он привязывает потребителей к ПРИВАТНОЙ схеме сервиса. Два правильных пути: либо трансформировать CDC в доменные события (Kafka Streams / Single Message Transforms в Connect), либо использовать transactional outbox — сервис сам кладёт уже ДОМЕННОЕ событие в outbox-таблицу в одной транзакции с бизнес-данными, а CDC/relay просто публикует строки outbox.
Eventual consistency и границы
В event-driven системе явно проектируют ГДЕ строгая транзакция (внутри одного сервиса и его БД), а где eventual consistency (между сервисами). Нельзя имитировать ACID между сервисами через каскад событий — будут гонки, частичные состояния и неконсистентные снимки.
Это влияет и на UI/API: пользовательский сценарий должен учитывать промежуточные состояния — payment_pending, shipment_requested, compensation_started — а не вид «всё атомарно». Граница «строгий vs eventual» — это бизнес-решение, и она должна быть явной в дизайне домена, а не «случиться» из-за плохой архитектуры.
Как отвечать на собеседовании
Объясните, почему в микросервисах отказались от 2PC, и опишите сагу как цепочку локальных транзакций + компенсаций; подчеркните, что компенсация — это БИЗНЕС-обратное действие, а не технический rollback (и сама обязана быть идемпотентной). Сравните хореографию (события, низкая связность, сложно наблюдать) и оркестрацию (координатор + state machine, явный процесс) с критерием выбора. Опишите CDC как чтение WAL/binlog (Debezium), его отличие от доменных событий и почему сырой CDC не стоит выпускать наружу → используют transactional outbox. Завершите тезисом о явной границе строгого/eventual consistency в UI и домене.