 sotto
Что делает ORM
ORM (Hibernate/JPA) сопоставляет объекты со строками таблиц и генерирует SQL для типовых операций. В рамках транзакции работает persistence context (кэш первого уровня) с identity map: одна и та же строка — один объект, а изменения отслеживаются и выгружаются на flush (dirty checking).
Цена удобства — потеря прямой видимости SQL: легко случайно породить дорогой сценарий, не заметив этого.
Lazy, eager и proxy
Связи бывают lazy и eager. По умолчанию в JPA коллекции (@OneToMany, @ManyToMany) ленивые, а @ManyToOne и @OneToOne — жадные: такая связь подгружается всегда, даже когда не нужна, и в списке сущностей тоже даёт N+1. Поэтому для связей «к одному» часто явно ставят fetch = FetchType.LAZY. Lazy-связь Hibernate отдаёт как proxy, а реальный запрос выполняется при первом обращении к данным.
Если обратиться к lazy-связи уже вне транзакции/сессии, получите LazyInitializationException. Поэтому решение «что грузить» принимают на этапе запроса, а не глобальной аннотацией.
Откуда берётся N+1
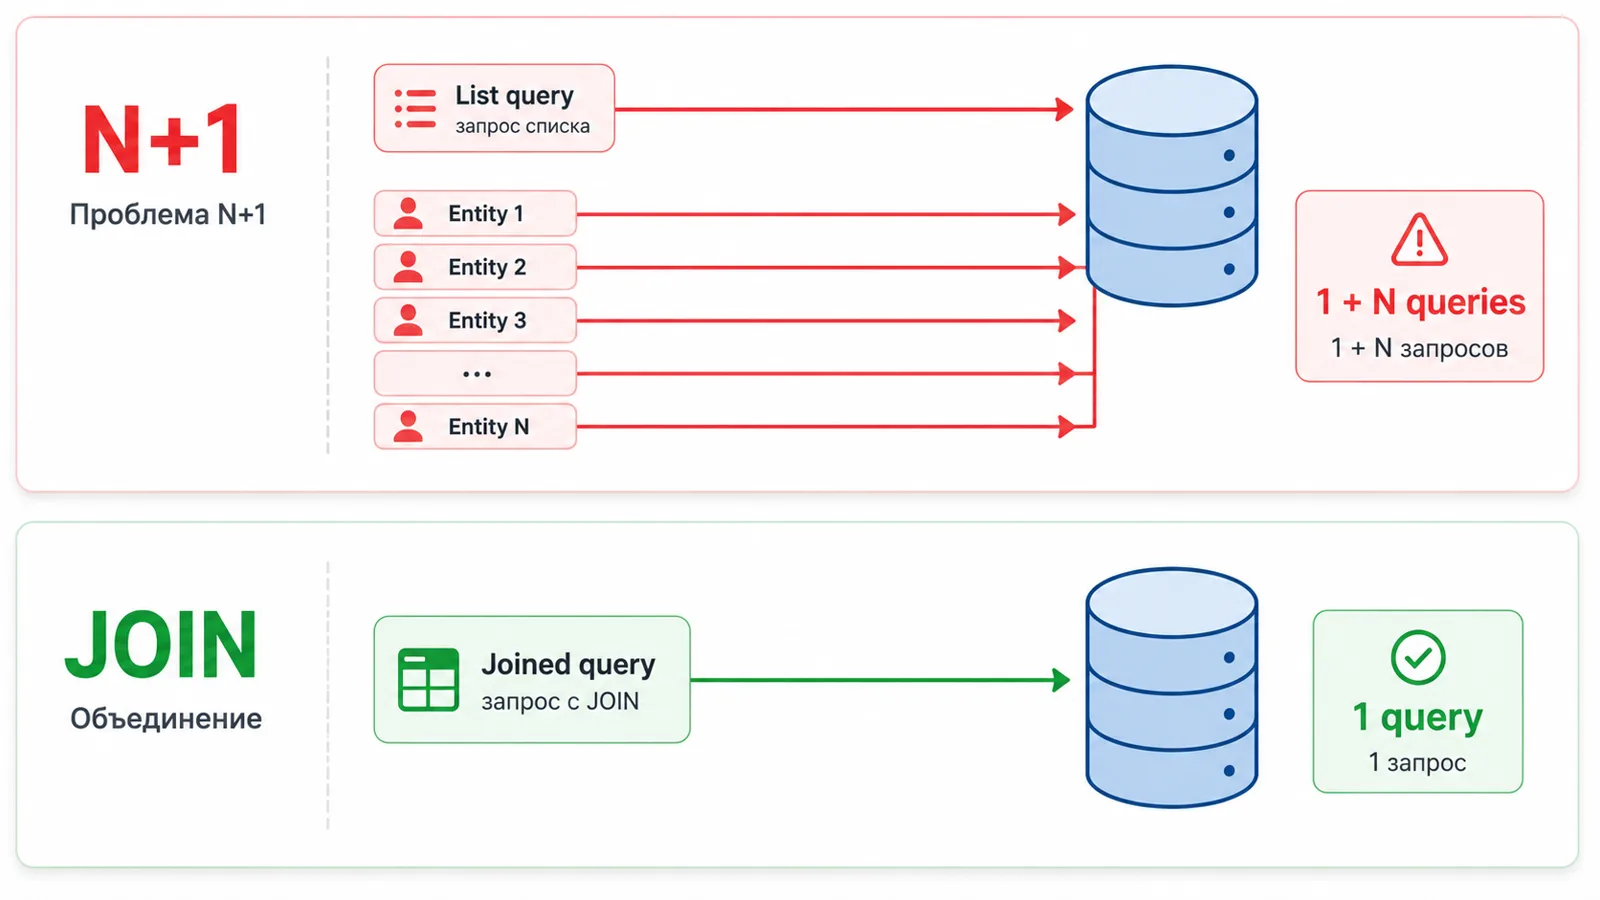
N+1 возникает, когда один запрос получает список из N сущностей, а затем для каждой выполняется ещё один запрос за её связью — итого 1 + N запросов вместо одного-двух.
Обнаруживают по SQL-логам (show_sql), p6spy или счётчику запросов в тестах. Симптом — рост числа запросов пропорционально размеру списка.
// 1 запрос за заказами + по запросу на orders.getItems() каждой строки
for (Order o : orderRepository.findAll()) {
    total += o.getItems().size(); // lazy → N запросов
}
Как лечить
JOIN FETCH или @EntityGraph подгружают связь одним запросом. Batch fetching (hibernate.default_batch_fetch_size) грузит связи пачками (1 + N/размер_пачки). DTO-проекция тянет только нужные поля одним запросом без полной загрузки сущностей.
@EntityGraph vs JOIN FETCH — это одно и то же по эффекту (превращают lazy-связь в один JOIN), но разные по форме: JOIN FETCH пишется прямо в JPQL/HQL, а @EntityGraph задаётся декларативно (аннотацией над репозиторием/именованным графом) и накладывается поверх обычного метода, не переписывая запрос. EntityGraph удобнее, когда один и тот же запрос нужен с разной «жадностью» загрузки.
Важная ловушка: JOIN FETCH коллекции вместе с пагинацией (setMaxResults/Pageable) Hibernate не может сделать на стороне БД — JOIN размножает строки, и чтобы отдать корректную «страницу сущностей», он тянет ВСЁ в память и режет там (в логах появляется предупреждение 'firstResult/maxResults specified with collection fetch; applying in memory'). На больших таблицах это OOM. Решения: пагинировать по id отдельным запросом, а затем дозагружать связи; или грузить коллекцию через batch fetching/EntityGraph без JOIN.
Выбор зависит от сценария: для отчётов чаще выгодны проекции, для навигации по графу — JOIN FETCH/EntityGraph.
@Query("select o from Order o join fetch o.items where o.userId = :uid")
List<Order> findWithItems(@Param("uid") Long uid);
Жизненный цикл сущности
Половина «магии» Hibernate объясняется четырьмя состояниями сущности. Transient — объект создан через new, персистентный контекст о нём не знает. Managed (persistent) — привязан к контексту: за ним следят, изменения полей попадут в БД. Detached — контекст закрыт, объект жив, но за ним больше никто не следит. Removed — помечен на удаление.
Отсюда вытекает dirty checking: у managed-сущности достаточно вызвать сеттер — никакого save() не нужно. На flush Hibernate сравнивает текущее состояние со снимком, сделанным при загрузке, и сам генерирует UPDATE. Обратная сторона: случайное изменение поля внутри транзакции молча уедет в БД.
Flush происходит не когда попало: перед выполнением запроса, затрагивающего изменённые сущности, и на commit транзакции. Важно не путать flush (SQL отправлен в БД, но транзакция не завершена) с commit (изменения зафиксированы и видны другим).
Кэш первого уровня (сам персистентный контекст) работает как identity map в границах транзакции: повторный find по тому же id не пойдёт в БД и вернёт ТОТ ЖЕ объект. Поэтому внутри одной транзакции сущности корректно сравнивать по ссылке, а вот equals/hashCode по изменяемым полям или по ещё не присвоенному id — источник трудноуловимых багов с коллекциями.
Detached-объекты возвращают в контекст через merge — он не делает объект managed, а КОПИРУЕТ его состояние в управляемый экземпляр и возвращает уже его. Игнорировать возвращённое значение merge — классическая ошибка: изменения уйдут в никуда.
@Transactional
void renameUser(Long id, String name) {
    User user = repository.findById(id).orElseThrow(); // managed
    user.setName(name);   // dirty checking: UPDATE сгенерируется на flush
}                          // save() вызывать не нужно
Грабли
Не лечите N+1 глобальным EAGER — это переносит проблему в другие сценарии и утяжеляет запросы. Не делайте JOIN FETCH двух коллекций сразу — получите декартово произведение строк. Помните про LazyInitializationException вне сессии.
Ещё три частые: отдавать сущности прямо из контроллера (сериализация тронет lazy-связи и породит запросы или исключение), писать equals/hashCode по сгенерированному id (до сохранения он null, после — объект «меняет» хеш внутри HashSet), и удалять по одной сущности в цикле там, где нужен один bulk-запрос.
Как отвечать на собеседовании
N+1 объясняйте механизмом, а не определением: один запрос вернул N сущностей, обращение к lazy-связи каждой из них выполняет ещё по запросу — итого 1 + N. Сразу скажите, как обнаруживаете проблему (show_sql, p6spy, счётчик запросов в тесте), это отличает практика от теоретика.
Перечислите средства с их профилем: JOIN FETCH и @EntityGraph — одним запросом (одно и то же по эффекту, но EntityGraph декларативен и не переписывает запрос); batch fetching — пачками, 1 + N/размер; DTO-проекция — только нужные поля, лучший вариант для отчётов. И подчеркните: EAGER не решение.
Сильный ход — назвать ловушку JOIN FETCH коллекции вместе с пагинацией: Hibernate не может сделать это на стороне БД, тянет всё в память и режет там (предупреждение firstResult/maxResults specified with collection fetch). Решение — пагинировать по id, а связи дозагружать отдельно.
Если спросят про внутренности — разложите четыре состояния (transient/managed/detached/removed), объясните dirty checking через снимок при загрузке и разведите flush и commit. Завершите общим тезисом: ORM экономит рутину, но не освобождает от обязанности знать, какой именно SQL уходит в базу.