 sotto
Зачем индекс и чем за него платят
Индекс — отдельная структура для быстрого поиска строк без полного сканирования таблицы. Он ускоряет выборки по подходящему условию, но имеет цену: каждый INSERT/UPDATE/DELETE должен обновить ещё и индекс, а сам индекс занимает место на диске и в памяти.
Поэтому индексировать «всё подряд» вредно: лишние индексы замедляют запись и могут не использоваться. Индексы добавляют под реальные паттерны запросов.
Как устроен B-tree
B-tree (точнее B+-tree) — сбалансированное дерево, где значения упорядочены, а листья связаны в список. Поиск, вставка и удаление — O(log n), а упорядоченность даёт бесплатно диапазоны (>, <, BETWEEN), сортировку (ORDER BY) и поиск по префиксу.
Именно из-за упорядоченности B-tree — индекс по умолчанию почти во всех СУБД: он покрывает и равенство, и диапазоны, и сортировку.
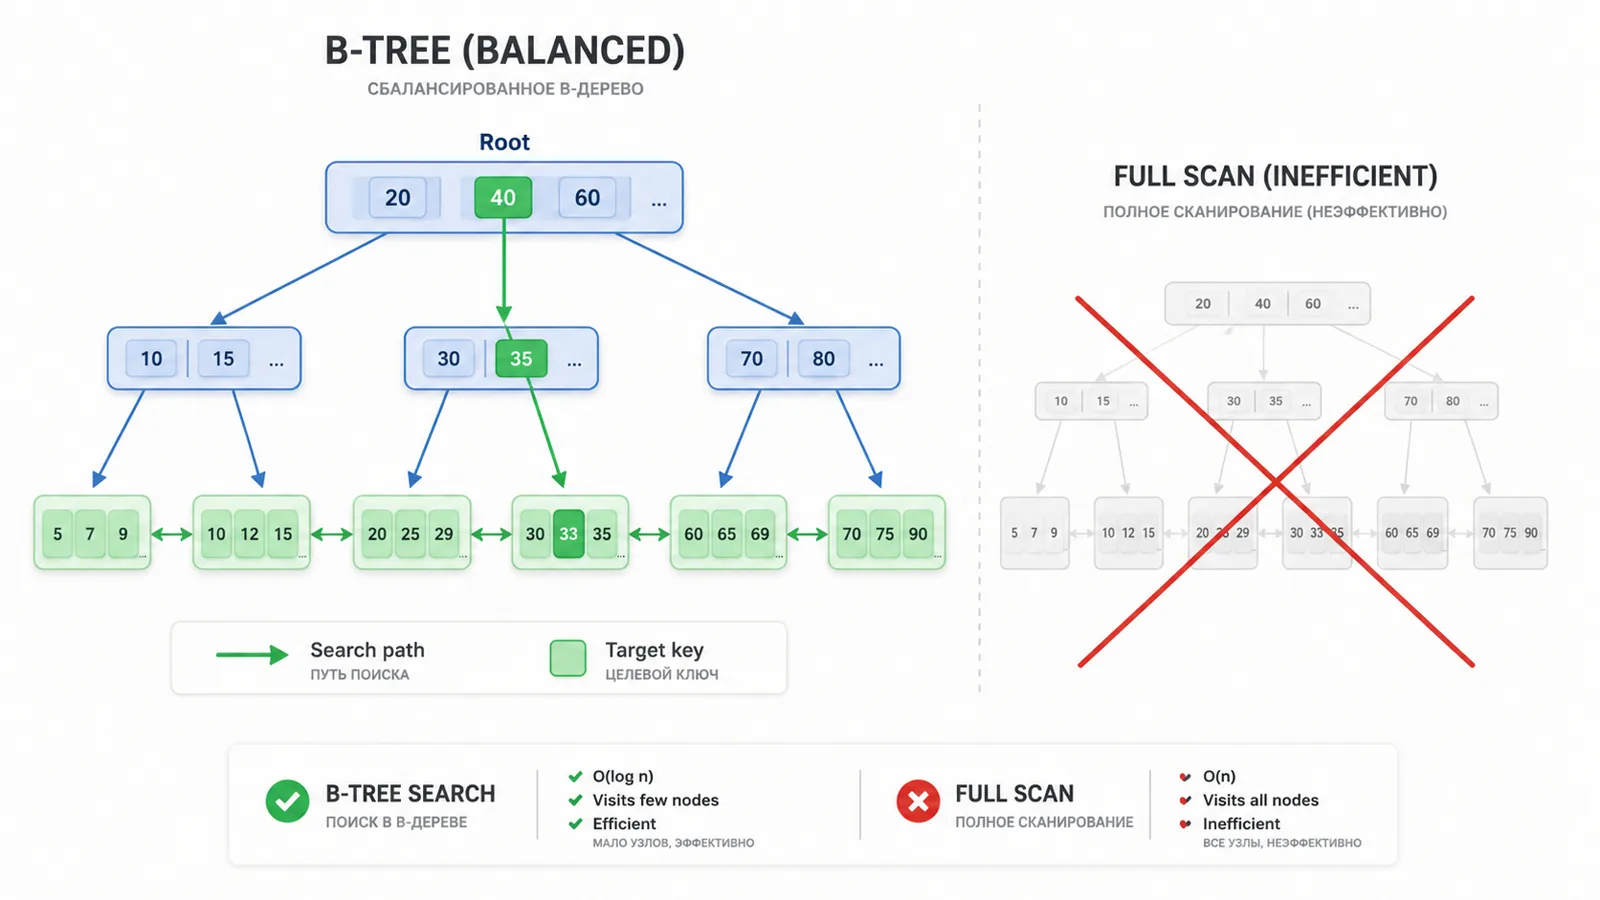
Hash против B-tree
Hash-индекс хранит хэш значения и хорош только для строгого равенства, зато поиск близок к O(1). Он не поддерживает диапазоны, сортировку и префиксы.
Вывод: hash оправдан в узких сценариях равенства при особых нагрузках, но универсальный выбор — B-tree.
Где лежит строка: clustered, non-clustered и heap
Индекс — это структура поиска, но важно ещё, где лежат сами данные строки. Кластерный индекс (clustered) задаёт физический порядок строк на диске: строки хранятся прямо в листьях B-tree этого индекса. Кластерный индекс может быть только один (нельзя разложить данные двумя способами сразу). В MySQL/InnoDB кластерный индекс — это первичный ключ (поэтому выбор PK влияет на раскладку всей таблицы).
Некластерный индекс (non-clustered) — отдельная структура: в её листьях лежат не строки, а указатели на строку. Если есть кластерный индекс, указатель — это значение ключа кластерного индекса; иначе таблица хранится как heap (куча, без порядка) и указатель — это физический адрес строки (RID/ctid).
Отсюда bookmark lookup (он же key/RID lookup): найдя строку в некластерном индексе, база делает второй переход за остальными колонками в кластерный индекс или heap. Это лишние чтения — именно поэтому covering index (включающий все нужные колонки) так выгоден: он убирает этот второй переход. У PostgreSQL модель чуть иная: таблица всегда heap, а кластеризацию даёт только разовая команда CLUSTER, не поддерживаемая автоматически.
Составной индекс и левый префикс
Составной индекс строится по нескольким колонкам в заданном порядке, и B-tree эффективно использует только левый префикс. Индекс (user_id, created_at) помогает запросам по user_id и по user_id + created_at, но не обязан помочь запросу по одному created_at.
Практическое правило построения порядка: сначала колонки с условием равенства, затем колонка диапазона/сортировки. Реальный выбор зависит от селективности и частоты запросов.
create index idx_orders_user_created
on orders (user_id, created_at desc);

-- использует индекс целиком (равенство + сортировка по префиксу)
select * from orders
where user_id = ?
order by created_at desc
limit 50;
Covering index
Covering index содержит все колонки, нужные запросу (в ключе или через INCLUDE), и тогда база отвечает прямо из индекса, не читая строки таблицы — это index-only scan.
Цена — более широкий индекс и чуть более дорогая запись. Выгодно для горячих запросов, читающих немного колонок.
Когда индекс не используется
Функция над колонкой в условии (lower(email) = ?) обычно ломает использование обычного индекса — нужен функциональный индекс или нормализованное хранение. LIKE '%abc' с ведущим символом подстановки тоже не использует B-tree.
При низкой селективности (условие отбирает большую долю таблицы) планировщик может сознательно выбрать полный скан как более дешёвый. Поэтому план всегда стоит проверять через EXPLAIN, а не угадывать.
Как отвечать на собеседовании
Сильный ответ связывает идею «индекс ускоряет чтение ценой записи и памяти» с устройством B-tree (упорядоченность → диапазоны и сортировка) и с левым префиксом составного индекса. Упомяните, что выбор подтверждают через EXPLAIN.