 sotto
Что такое JOIN
JOIN соединяет строки двух таблиц по условию (ON). Концептуально база перебирает пары строк и оставляет те, что удовлетворяют условию, а тип JOIN определяет, что делать с непарными строками.
Как именно выполняется соединение (nested loop, hash join, merge join) выбирает планировщик по объёму данных и индексам — это разные алгоритмы с разной стоимостью.
Виды JOIN
INNER JOIN оставляет только совпавшие пары. LEFT (OUTER) JOIN сохраняет все строки левой таблицы, подставляя NULL там, где справа нет пары; RIGHT JOIN — зеркально. FULL OUTER JOIN сохраняет непарные строки с обеих сторон.
CROSS JOIN даёт декартово произведение (каждая с каждой) — иногда нужно, но чаще это случайно забытое условие соединения.
-- все пользователи и их заказы; пользователи без заказов тоже попадут (с NULL)
select u.id, o.id
from users u
left join orders o on o.user_id = u.id;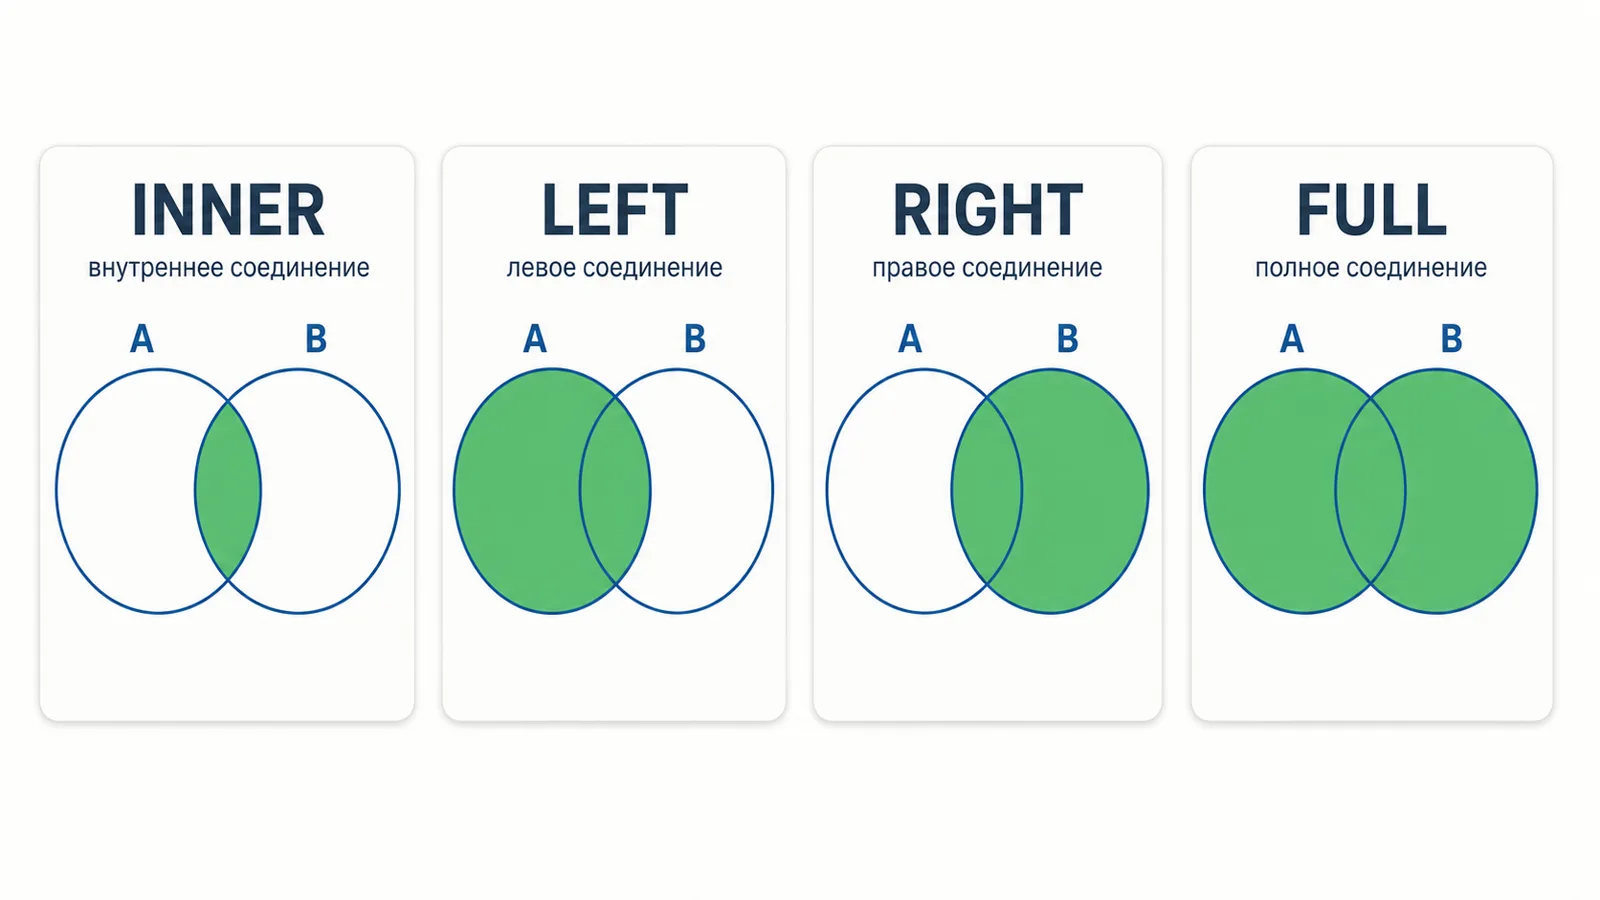
ON против WHERE — ловушка OUTER JOIN
Для INNER JOIN условие можно ставить хоть в ON, хоть в WHERE — результат одинаков. Для OUTER JOIN это не так.
Условие на правую таблицу в WHERE отбрасывает строки, где она равна NULL, и LEFT JOIN тихо превращается в INNER. Если фильтр должен применяться к правой таблице, но при этом сохранять непарные левые строки — его место в ON.
-- хотим всех users + их PAID-заказы, сохранив users без заказов
select u.id, o.id
from users u
left join orders o
  on o.user_id = u.id and o.status = 'PAID'; -- условие в ON, а не в WHERE
Ключи и ограничения
Primary key — основной идентификатор строки: уникален, не допускает NULL, обычно один на таблицу и служит целью для внешних ключей. Естественный ключ (email) против суррогатного (auto id) — частый предмет обсуждения; суррогатный стабильнее, естественный экономит join.
Unique constraint выражает бизнес-уникальность (email, номер заказа в рамках tenant), и таких ограничений может быть несколько. Foreign key связывает колонку с ключом другой таблицы и обеспечивает ссылочную целостность.
Составной ключ (PK или unique по нескольким колонкам) уместен, когда строку идентифицирует комбинация значений, например (tenant_id, order_no).
Ссылочная целостность и индексы под FK
Foreign key не даёт создать ссылку на несуществующую строку и контролирует поведение при удалении/обновлении родителя (CASCADE, RESTRICT, SET NULL).
Важная деталь: внешний ключ часто стоит проиндексировать вручную. PK индексируется автоматически, а вот столбец-источник FK — нет, и без индекса каскадные удаления и join по нему становятся дорогими.
Три алгоритма соединения
Тип JOIN (INNER/LEFT) — это СЕМАНТИКА, какие строки попадут в результат. Алгоритм соединения — это РЕАЛИЗАЦИЯ, выбираемая планировщиком; путать их на собеседовании не стоит.
Nested loop: для каждой строки внешней таблицы ищем пары во внутренней. Дёшев, когда внешняя выборка мала, а внутренняя имеет индекс по колонке соединения — тогда каждый поиск это спуск по B-tree. Без индекса вырождается в квадратичный перебор.
Hash join: по меньшей таблице строится хеш-таблица в памяти, затем по ней проверяются строки большей. Хорош для больших наборов без индексов, но работает только с равенством (=) и требует памяти; при нехватке уходит на диск.
Merge join: обе стороны сортируются по ключу соединения и проходятся параллельно, как слияние двух отсортированных списков. Выгоден, когда данные уже отсортированы (например, читаются по индексу), иначе платим за сортировку.
Практический вывод: если в плане вместо ожидаемого index nested loop оказался seq scan + hash join на миллионах строк, обычно не хватает индекса по колонке соединения (чаще всего — по внешнему ключу).
Частые ошибки
Ловушки: переносить условие правой таблицы из ON в WHERE при OUTER JOIN, путать LEFT и RIGHT, забывать индекс на FK, полагаться только на проверки в коде вместо constraints в БД.
Ещё одна: считать, что JOIN «размножает» строки по ошибке. Если после соединения строк стало больше, значит связь на самом деле один-ко-многим — и вопрос не к JOIN, а к тому, что мы хотели получить (агрегат, DISTINCT или отдельный запрос).
Как отвечать на собеседовании
Опишите JOIN через судьбу непарных строк: INNER отбрасывает, LEFT сохраняет левые с NULL, FULL — обе стороны. Это точнее, чем пересказ диаграмм Венна, и сразу выводит на семантику NULL.
Обязательно назовите ловушку ON против WHERE: условие на правую таблицу в WHERE отбрасывает NULL-строки и превращает LEFT JOIN в INNER — это любимая проверка на понимание, а не на память.
По ключам разведите роли: PK — идентификатор строки, unique — бизнес-правило (их может быть несколько), FK — ссылочная целостность плюс поведение при удалении родителя (CASCADE/RESTRICT/SET NULL). Добавьте деталь, которая отличает практика: PK индексируется автоматически, а колонку-источник FK надо индексировать самому, иначе каскады и соединения по ней дорогие.
Если спросят про производительность соединения — назовите nested loop / hash / merge и условие, при котором каждый выгоден. Завершите тезисом: критичные инварианты держим ограничениями в БД, потому что код можно обойти багом или вторым сервисом.